Bảo mật AI là điều chúng tôi được xây dựng để làm. Một lần đánh giá không cần agent tìm ra mọi AI bạn đang vận hành — các tác nhân, mô hình và khóa chưa ai đăng ký — và một đồ thị liên kết chúng với mã nguồn, đám mây và dữ liệu của bạn, để tổ hợp độc hại trải dài qua nhiều tầng là rủi ro bạn nhìn thấy đầu tiên. Với những rủi ro nghiêm trọng, một bộ máy tự động chứng minh kẻ tấn công thực sự có thể chạm tới đâu: một khai thác chạy được, không bao giờ chỉ là một điểm số. Trên một tài khoản production thật, điều đó đã biến 17 phát hiện thành đúng một rủi ro quan trọng, kèm bằng chứng bạn có thể trao cho kiểm toán viên, hội đồng quản trị, hoặc chính các kỹ sư của mình.
Một đồ thị rủi ro chỉ hữu ích khi con người có thể hành động dựa trên nó. Đồ thị của chúng tôi chứa 533 nút và 26.314 cạnh cho một tài khoản AWS quy mô vừa — số liệu thật từ một hệ thống thật. In ra dưới dạng danh sách thì không thể đọc nổi. Vẽ tất cả cùng lúc thì thành một mớ bòng bong. Redthread Flow là cách chúng tôi khiến một đồ thị cỡ đó trả lời một câu hỏi chỉ trong một màn hình.
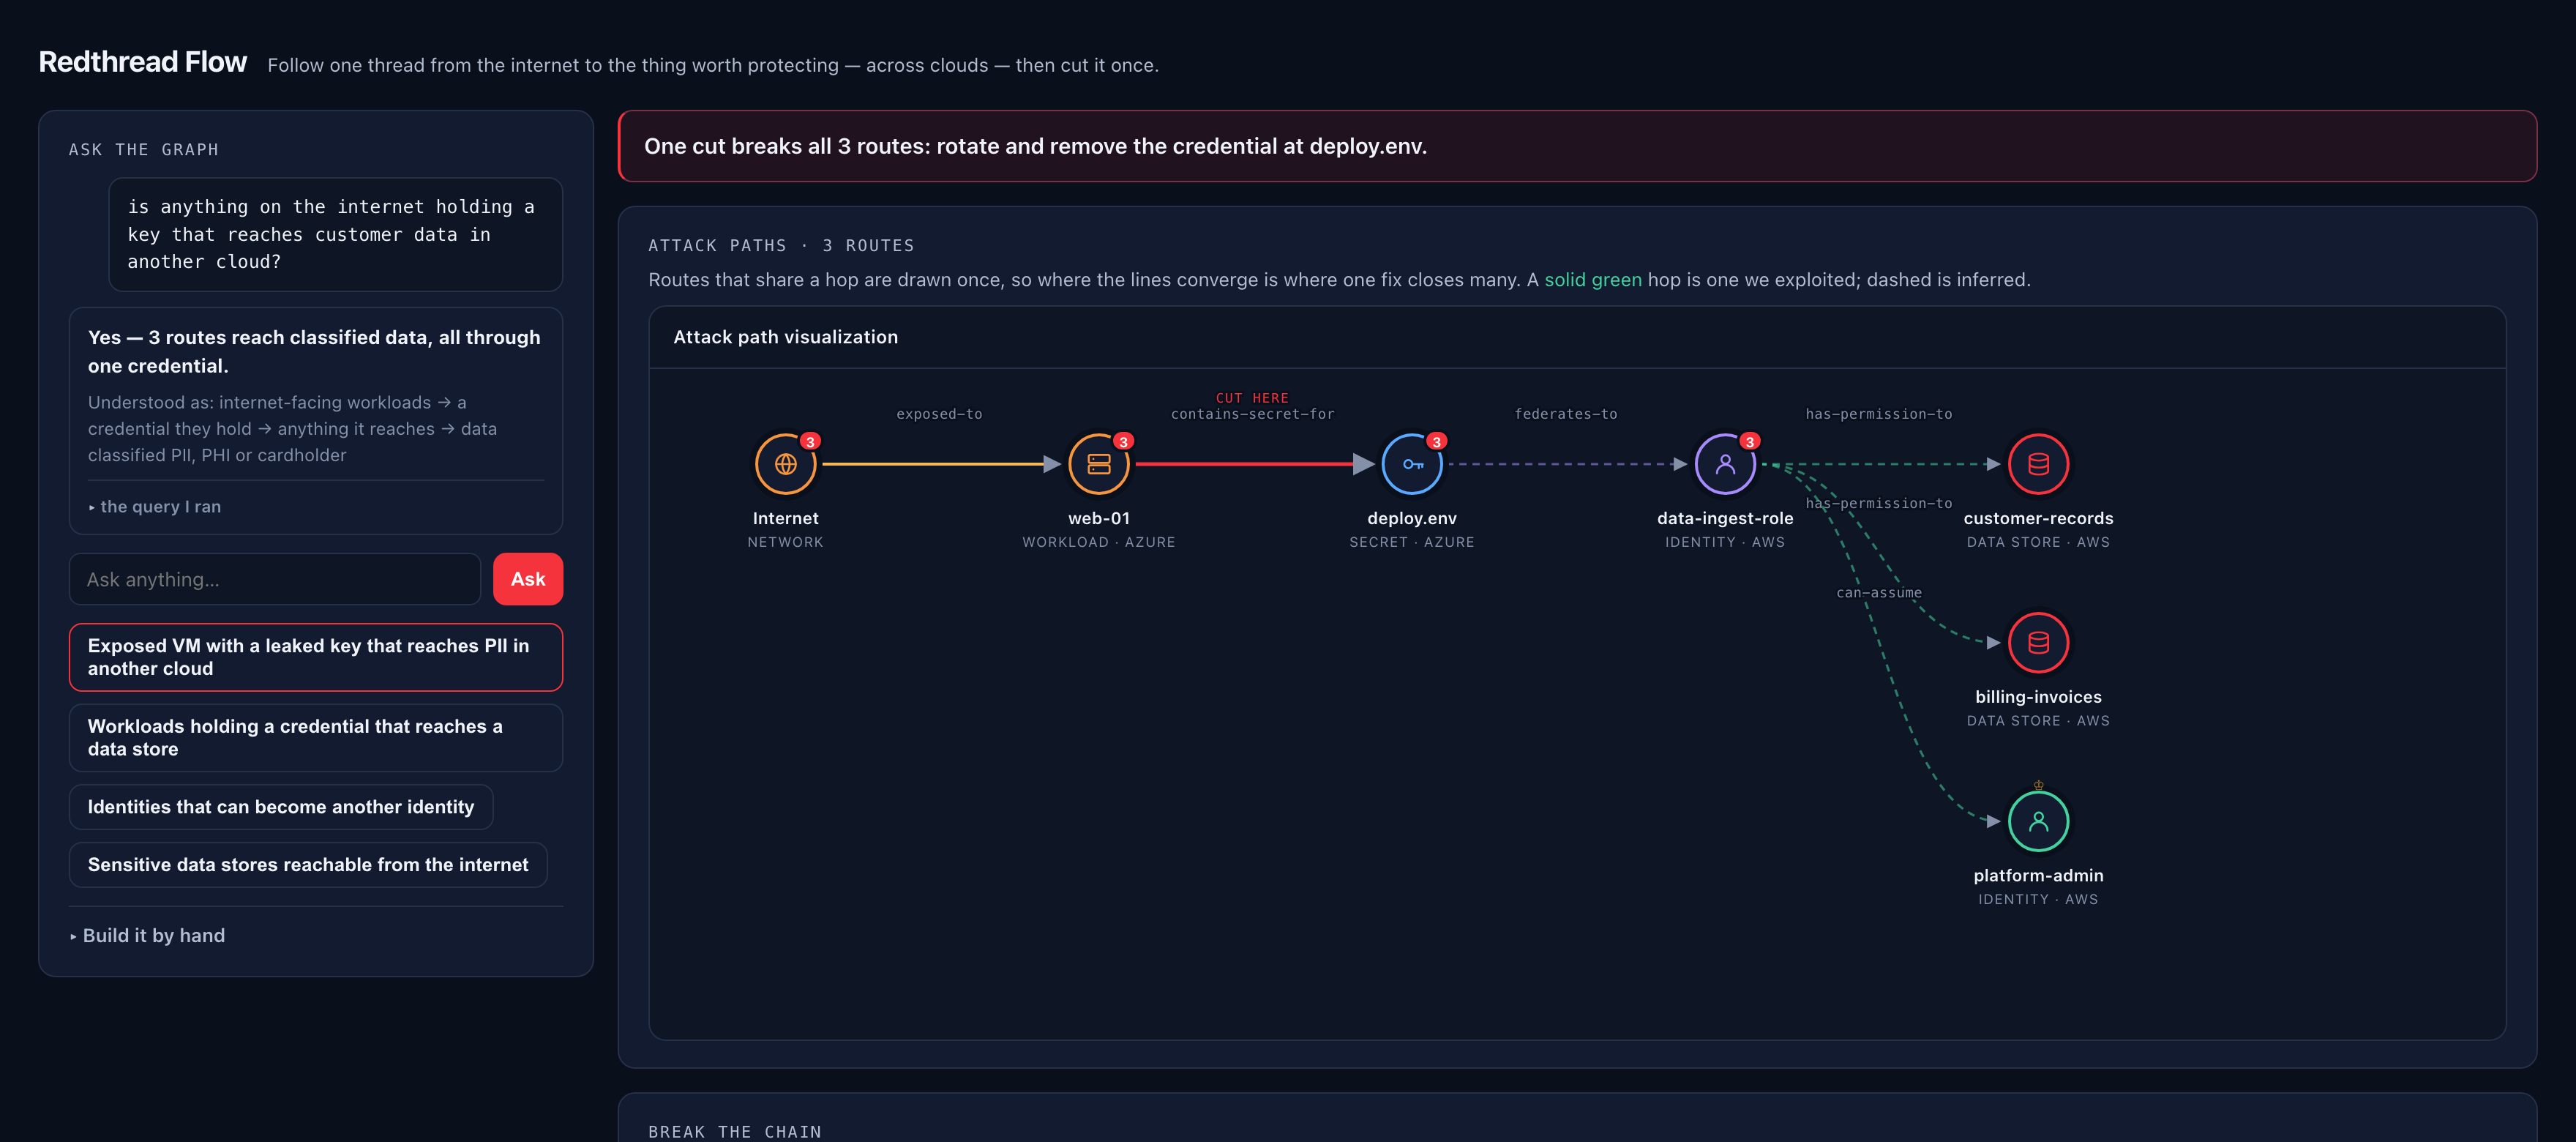
Bảng điều khiển trả lời những câu hỏi mà người tạo ra chúng đã dự liệu. Câu hỏi quan trọng nhất khi xảy ra sự cố — "liệu có thứ gì hướng ra internet chạm tới được cơ sở dữ liệu thanh toán không?" — thì không bao giờ có trong danh sách. Redthread Flow tiếp nhận câu hỏi đó bằng ngôn ngữ tự nhiên, chuyển nó thành một truy vấn đồ thị có cấu trúc, và cho bạn thấy truy vấn đó. Nếu nó hiểu sai ý bạn, bạn sẽ thấy ngay là nó đã hiểu sai.
Mọi tuyến đường được trả về đều đúng, và vẽ tất cả chúng ra sẽ tạo nên một bức tranh không ai dùng được. Chúng tôi vẽ vài tuyến đầu tiên và nói rõ điều đó — tổng số và các điểm cắt được đề xuất luôn được tính trên mọi kết quả khớp, không bao giờ chỉ trên tập con được vẽ. Một bức tranh nhỏ hơn không bao giờ được hiểu như một câu trả lời nhỏ hơn.
Năm mươi đường tấn công có thể chung một bước nhảy. Chúng tôi xếp hạng mọi bước nhảy theo số tuyến đường bị triệt tiêu nếu bạn cắt nó, để mục đầu danh sách là một thay đổi đáng giá bằng năm mươi phiếu công việc. Trên một tài khoản đang hoạt động, điểm cắt hàng đầu — xoay vòng một thông tin xác thực — đã đóng 86 trên 1.382 đường tấn công.
Chúng tôi vẽ một luồng phân tầng từ trái sang phải, không phải một đám mây bố cục theo lực. Một đường tấn công là một chuỗi có thứ tự ; bố cục mô phỏng vật lý che giấu cả thứ tự lẫn hướng đi của nó — vốn là hai điều duy nhất bạn cần. Nơi các tuyến đường chung một bước nhảy, chúng hội tụ lại — nên chính hình dạng của bức tranh đã thể hiện thứ tự ưu tiên.
Một bước nhảy nét liền đã được bộ máy kiểm thử xâm nhập của chúng tôi thực thi, kèm theo yêu cầu. Một bước nhảy nét đứt tồn tại trong cấu hình nhưng chưa bao giờ được chạy. Màu sắc thể hiện nút đó là gì — dữ liệu đã phân loại và tài sản hướng ra internet có vòng viền riêng, danh tính đặc quyền có biểu tượng vương miện — để mức nghiêm trọng được nhận ra trước khi đọc bất kỳ nhãn nào.
Toàn bộ đồ thị có thể xuất ra dưới dạng JSON node-link thuần túy. Không có kho lưu trữ độc quyền, không có ngôn ngữ truy vấn phải học, không bị khóa chặt: duyệt nó bằng công cụ của riêng bạn, so sánh hai bản xuất để xem điều gì đã thay đổi trong quý này, hoặc trao nó cho kiểm toán viên. Bộ máy là của chúng tôi; đồ thị là của bạn.
Kiểm kê tự động mọi tính năng dùng AI trong môi trường của bạn — kể cả những tính năng mà không ai báo cho bộ phận bảo mật. AI ngầm sẽ không còn ngầm nữa.
Với mọi tài sản được khám phá, liệt kê bề mặt tấn công thực tế — những mô hình nào đang được dùng, một tác nhân có thể chạm tới những công cụ và nguồn dữ liệu nào, những ranh giới phân quyền nào đang tồn tại (và chỗ nào không có).
Kiểm thử tự động, có bằng chứng khái niệm làm căn cứ, trên bề mặt đó — prompt injection, lạm dụng công cụ/tác nhân, rò rỉ dữ liệu, lỗi ranh giới phân quyền — chạy theo lịch định kỳ và tự động kích hoạt lại khi tài sản thay đổi, để các phát hiện không bị lỗi thời giữa các đợt rà soát thủ công.
Các phát hiện ánh xạ trực tiếp tới OWASP LLM Top 10 và đi thẳng vào bằng chứng tuân thủ mà kiểm toán viên của bạn vẫn yêu cầu (SOC 2 CC4/CC7, ISO 42001 và tương tự) — kèm góc nhìn xu hướng theo thời gian, không chỉ một ảnh chụp nhanh, để bạn chứng minh được rủi ro đang thực sự giảm xuống.
Hầu hết các nền tảng bảo mật AI trao cho bạn một điểm rủi ro nói rằng có điều gì đó có thể sai mà không cho bạn thấy đó là gì. Mọi phát hiện của Redthread đều có một bằng chứng khái niệm chạy được làm căn cứ, đúng như cách một chuyên gia kiểm thử xâm nhập ghi nhận. Kỹ sư của bạn nhận được thứ có thể tái hiện và khắc phục — và khi kiểm toán viên hay khách hàng hỏi "làm sao bạn biết", bạn có câu trả lời.
Việc kiểm thử chạy theo lịch và tự kích hoạt lại khi có thay đổi, để tư thế rủi ro của bạn phản ánh những gì thực sự đang chạy trên production tuần này — không phải những gì đúng vào lúc dự án gần nhất được xác định phạm vi.
Chặn một lần triển khai dựa trên phát hiện, hoặc chỉ nhận thông báo — kết nối vào pipeline mà các đội của bạn đang dùng.
Mọi phát hiện đều được cấu trúc để ánh xạ tới các khung tiêu chuẩn mà đội tuân thủ của bạn phải đáp ứng.
Ngoài hệ thống AI: trỏ nó vào một dải IP được ủy quyền và nó sẽ chạy trinh sát → liệt kê dịch vụ → xác nhận (naabu → nmap → nuclei), rồi trao cho bạn các phát hiện đã được xác nhận kèm bằng chứng. Chỉ xác nhận — nó phát hiện và xác nhận, không khai thác.
Mỗi phát hiện là một host:port kèm dịch vụ, CVE hoặc điểm phơi lộ, và bằng chứng chính xác — ánh xạ tới CVE · CWE · MITRE. Không khai thác, không tấn công từ chối dịch vụ.
Một lần quét chỉ chạy trên dải địa chỉ bạn được ủy quyền kiểm thử — văn bản ủy quyền có chữ ký cùng bằng chứng sở hữu CIDR, kèm kiểm tra chính sách của nhà cung cấp đám mây. Các dải quá rộng sẽ bị từ chối.
Các phát hiện ánh xạ tới PCI DSS 4.0 §11.4 và SOC 2 (CC4.1/CC7.1/CC6.6); một lần quét lại hằng đêm so sánh bề mặt tấn công và gắn cờ các thay đổi về phân vùng mạng — bằng chứng kiểm thử sau một thay đổi đáng kể.
Mọi công cụ kiểm tra tư thế bảo mật đều có thể cho bạn biết một bucket đang công khai. Không công cụ nào cho bạn biết kẻ tấn công thực sự có thể chạm tới bucket nào — vì câu trả lời đó không nằm trong một danh sách, mà nằm trong một đồ thị. Redthread, bộ máy đồ thị của chúng tôi, lập bản đồ toàn bộ hệ thống của bạn thành một bức tranh — tác nhân, repository, khối lượng công việc, danh tính, route mạng và kho dữ liệu, cùng các mối quan hệ giữa chúng — rồi xếp hạng các đường tấn công xuyên qua đó. Đây cũng chính là bộ máy đứng sau cổng kiểm soát pull request, trình dựng truy vấn và báo cáo đường tấn công, vì vậy tất cả đều nhất quán với nhau.
Một phát hiện nói rằng "bucket này đang công khai." Một rủi ro nói rằng "internet chạm tới khối lượng công việc này, nơi giữ một thông tin xác thực, thứ đọc được dữ liệu khách hàng của bạn." Trên một tài khoản AWS thật, điều này đã biến 17 phát hiện thành 1 rủi ro — vì một bucket công khai là một phát hiện, còn một bucket công khai chứa dữ liệu cá nhân là một vụ rò rỉ.
Những bên khác xếp hạng những gì có thể bị khai thác. Chúng tôi còn chạy một bộ máy kiểm thử xâm nhập tự động — nên một số cạnh trong đồ thị của bạn là những cạnh chúng tôi đã thực sự khai thác, kèm yêu cầu và bằng chứng. Đã chứng minh luôn xếp trên lý thuyết, và báo cáo không bao giờ làm mờ ranh giới giữa hai thứ đó.
Một danh tính Entra ID được một vai trò AWS tin cậy. Một pool GCP tin cậy một tài khoản AWS. Công cụ riêng của mỗi nhà cung cấp đều không thấy được những điều này, vì mỗi bên chỉ nhìn vào chính mình — và chỉ cần một đám mây được kết nối là đủ để làm lộ diện điểm phơi lộ.
Lấy mẫu có giới hạn phân loại những gì thực sự nằm trong kho dữ liệu của bạn — dữ liệu cá nhân, dữ liệu thẻ thanh toán, dữ liệu sức khỏe, thông tin xác thực — thông qua vai trò không cần agent mà bạn đã cấp. Số thẻ được kiểm tra bằng thuật toán Luhn, nên một mã đơn hàng 16 chữ số không bao giờ trở thành một phát hiện PCI. Chưa gắn nhãn thì vẫn là chưa xác định; chúng tôi không bao giờ phỏng đoán.
Mỗi pull request đều được đánh giá dựa trên đồ thị đang hoạt động của bạn. Một bucket riêng tư, đã mã hóa không có phát hiện nào khi xét riêng — nhưng vẫn ở mức nghiêm trọng nếu một vai trò hiện có, có thể truy cập từ internet, đã đọc được nó. Một công cụ lint IaC độc lập về bản chất không thể nói được điều đó.
Chúng tôi phát hiện và ký; một hàm do bạn triển khai sẽ nắm giữ thông tin xác thực và thực hiện thay đổi. Quyền truy cập của chúng tôi vẫn không cần agent, nếu chúng tôi bị xâm phạm thì cũng không thể thay đổi đám mây của bạn, và mọi thay đổi đều nằm trong nhật ký kiểm toán của chính bạn. Kèm theo Lambda và Terraform tham chiếu.
Một bản vá bảo mật do máy viết đặt ra một câu hỏi: nó đã thực sự sửa được lỗi, hay chỉ trông như vậy? Mọi nhà cung cấp đều trả lời bằng một ý kiến khác — bên thì chạy lại trình quét trên bản vá, bên thì hỏi một mô hình thứ hai xem nó có vẻ đúng không. Cả hai vẫn chỉ là phỏng đoán về đoạn mã.
Chúng tôi giữ lại khai thác. Mọi phát hiện đều kèm một bằng chứng khái niệm chạy được, có thể chạy lại, nên chúng tôi có thể phân định theo cách duy nhất có giá trị: chạy lại cuộc tấn công ban đầu trên bản build đã vá của bạn. Nếu nó vẫn thành công, chúng tôi nói rõ điều đó ngay trong pull request, trước khi bạn hợp nhất. Một trình quét không có gì để chạy lại — đó là lý do không ai khác cung cấp điều này.
Một bản sửa chỉ được đánh dấu là đã xác minh khi khai thác tái hiện được trước khi vá và bị chặn sau khi vá. Không có mốc chuẩn thì không có tuyên bố — nếu chúng tôi chưa từng xâm nhập được trước đó, một lượt chạy sạch sau đó không chứng minh được gì và chúng tôi ghi chưa kết luận được thay vì tô vẽ cho nó.
Với những mẫu lỗi chúng tôi gặp lặp đi lặp lại, một phép biến đổi viết tay thay thế hoàn toàn mô hình: cùng đầu vào, cùng đầu ra, mọi lúc. Dữ liệu ngành đã công bố cho thấy các bản sửa bảo mật do AI viết có tỷ lệ được hợp nhất dưới 10%; chính các bản sửa tất định mới cải thiện được con số đó.
Các bản sửa do mô hình viết phải qua một vòng rà soát riêng nhằm tìm lý do để bác bỏ. Một bản vá làm im lặng trình quét, nuốt ngoại lệ, xóa hàm hoặc mã hóa cứng một thông tin xác thực sẽ bị loại bỏ — và pull request nêu rõ những gì chúng tôi đã loại bỏ.
Chúng tôi đã thu gọn nhiễu theo khả năng chạm tới — 17 phát hiện trở thành 1 rủi ro trên một tài khoản thật, vì chỉ một trong số đó có thể chạm tới được. Đây là trục thứ hai: khi nhiều rủi ro cùng truy ngược về một stack CloudFormation hoặc một mô-đun Terraform, bạn nhận được đúng một nơi cần sửa, không phải một hàng đợi. CloudFormation tự gắn thẻ cho tài nguyên của nó, nên việc truy vết đó chính xác và không cần bạn làm gì.
Điều chúng tôi sẽ không làm là phỏng đoán. Một tài nguyên không có liên kết rõ ràng ngược về mã nguồn thì không có nguồn gốc — chúng tôi hiển thị nó riêng thay vì xếp nó vào một mô-đun có thể chẳng liên quan gì. Một nguyên nhân gốc sai sẽ đưa kỹ sư tới sai tệp và kéo theo cả bốn mươi phát hiện tiếp theo.
Quét đám mây và hạ tầng, kiểm thử xâm nhập ứng dụng AI, khám phá AI ngầm, phân tích quyền hạn tác nhân, tư thế bảo mật dữ liệu, rủi ro liên đám mây, kiểm soát từ mã nguồn đến đám mây, khắc phục, và truy vấn đồ thị. Nếu ghép lại theo cách hiện nay, đó là một CNAPP, một công cụ DSPM, một sản phẩm bảo mật AI và một công ty kiểm thử xâm nhập — bốn bảng điều khiển, bốn hợp đồng, và một người trong đội của bạn được trả lương để đối chiếu bốn bộ phát hiện không hề biết gì về nhau. Ở đây chúng cùng đọc và ghi trên một đồ thị, vì vậy một phát hiện ở chỗ này hoàn thiện một đường tấn công ở chỗ khác thay vì rơi vào một hàng đợi khác.
Kết nối một vai trò không cần agent và không có gì được cài lên máy chủ của bạn. Mọi thông tin xác thực đều được xác minh bằng một lệnh gọi thật trước khi lưu trữ, nên một lỗi đánh máy sẽ báo lỗi ngay lúc kết nối — chứ không âm thầm hỏng lúc 3 giờ sáng.
Các câu hỏi đã lưu cùng một trình dựng cho những câu hỏi chưa ai viết sẵn: máy ảo bị lộ ra internet, chứa một khóa dạng văn bản thuần, chạm tới một kho dữ liệu có dữ liệu cá nhân. Câu trả lời trả về dưới dạng các đường tấn công kèm bằng chứng ở từng bước nhảy. Xuất đồ thị và tự mình duyệt nó — định dạng là mở.
Các kho dữ liệu được lấy dấu vân tay lược đồ, nên một bản sao dữ liệu production nằm trong bucket staging sẽ được nhận diện là bản sao — và được nâng mức khi bản sao đó cũng bị lộ ra internet. Với các cơ sở dữ liệu không được quản lý trên ổ đĩa máy ảo, một worker tạm thời chạy ngay trong tài khoản của bạn và chỉ gửi đi các phát hiện; nội dung không bao giờ rời khỏi tài khoản.
Các phát hiện từ GuardDuty, Security Hub và Inspector được đưa vào cùng một đồ thị Redthread, nơi chúng hoàn thiện những đường đi mà từng công cụ riêng lẻ không thấy. Cùng tồn tại, không thay thế — và không cần agent. Có cảm biến runtime eBPF tùy chọn khi bạn muốn đi sâu hơn.
Phát hiện rủi ro trên production là đã muộn. Cùng đồ thị xếp hạng các đường tấn công đang tồn tại của bạn cũng đánh giá một thay đổi trước khi nó được phát hành — để tổ hợp nguy hiểm không bao giờ chạm tới đám mây của bạn. Đã hoạt động trong các pull request của bạn ngay hôm nay, và đang mở rộng tới cluster và mặt phẳng điều khiển đám mây.
Các manifest Terraform, CloudFormation, ARM và Kubernetes được kiểm tra trên mọi PR. Một thay đổi khai báo cấu hình sai nghiêm trọng, commit một thông tin xác thực, hoặc tạo ra một đường tấn công nghiêm trọng sẽ không vượt qua bài kiểm tra và được chú thích ngay trên dòng mã — kèm đường tấn công, không chỉ một mã quy tắc.
Một công cụ lint chỉ thấy một template. Chúng tôi hợp nhất các tài nguyên dự kiến vào đồ thị Redthread đang hoạt động của bạn. Một bucket riêng tư, đã mã hóa không có phát hiện nào khi xét riêng — nhưng vẫn ở mức nghiêm trọng nếu một vai trò hiện có, có thể truy cập từ internet, đã đọc được nó. Ngữ cảnh đó chính là mấu chốt.
Cổng kiểm soát chỉ đánh trượt những gì mà diff của bạn chịu trách nhiệm. Rủi ro có sẵn trong tài khoản không bao giờ chặn một pull request — vì đó là cách một cổng kiểm soát bị người ta tắt đi. Chế độ chỉ báo cáo chỉ cần một dòng nếu bạn muốn có tín hiệu trước khi thực thi.
Cùng cách đánh giá dựa trên đồ thị, áp dụng tại hai điểm nghẽn nữa. Khách hàng Doanh nghiệp định hình thứ tự ưu tiên — hãy trao đổi với chúng tôi nếu một trong hai nằm trên lộ trình trọng yếu của bạn.
Từ chối một khối lượng công việc tại Kubernetes API server khi việc chấp nhận nó sẽ hoàn thiện một đường tấn công — service account của pod này cách dữ liệu cá nhân (PII) của bạn ba bước nhảy, và nó đang bị lộ ra internet. Một policy engine chỉ đọc manifest không thể diễn đạt được điều đó.
Service control policy, Azure Policy và GCP Org Policy khiến cấu hình sai không thể được tạo ra — được đề xuất từ chính các phát hiện bạn đang có, do bạn áp dụng, và được nhà cung cấp đám mây của bạn thực thi. Không cần agent ở bất cứ đâu.
Cô lập hoặc dừng một khối lượng công việc khi có phát hiện runtime đã được xác nhận. Cố ý để sau cùng: một sai sót khi thực thi chính là một sự cố ngừng dịch vụ, nên tính năng này được triển khai sau giai đoạn ưu tiên kiểm toán và một công tắc ngắt khẩn cấp đã được kiểm thử, không bao giờ là mặc định.
Những người cần bằng chứng rằng bạn đã kiểm thử hiếm khi là những người được phép biết cách chúng tôi đã xâm nhập. Một lần đánh giá tạo ra ba tài liệu, để bạn không bao giờ phải chọn giữa việc trả lời một bảng câu hỏi và việc bảo vệ một khai thác chạy được nhắm vào chính hệ thống của bạn.
Tên pháp lý của bạn, ngày kiểm thử chính xác, phạm vi, phương pháp, số lượng theo mức nghiêm trọng và chữ ký — và hoàn toàn không có chi tiết khai thác nào. Gửi nó cho cuộc rà soát bảo mật của khách hàng tiềm năng hoặc một bảng câu hỏi đánh giá rủi ro bên thứ ba mà không cần qua lại ký NDA hay một lượt biên tập che thông tin.
Mười ba phần, viết theo cấu trúc mà PTES, NIST SP 800-115, OWASP WSTG và CREST yêu cầu: trang bìa và kiểm soát tài liệu, quy tắc thực hiện, mọi phát hiện kèm điểm và vector CVSS, lộ trình khắc phục, bảng đối chiếu các khung tiêu chuẩn, chữ ký.
Cùng báo cáo đó dưới dạng dữ liệu có cấu trúc, để nó đi thẳng vào Vanta, Drata hoặc Secureframe thay vì phải nhập lại thủ công. Các phát hiện mang theo lớp OWASP LLM 2025, kỹ thuật MITRE ATLAS và ánh xạ biện pháp kiểm soát.
Một vector CVSS không bao giờ được bịa ra — đó là điểm khuyến cáo thật hoặc vector cơ sở chuẩn cho lớp lỗ hổng, được gắn nhãn rõ ràng. Một hạng mục đã kiểm thử mà không tìm thấy gì được báo cáo đúng như vậy, không bao giờ là "sạch". "Đã khắc phục" chỉ xuất hiện khi một lần kiểm thử lại thực sự đạt. Người rà soát chỉ được nêu tên nếu thực sự có con người rà soát. Và không có gì trong đó tự nhận là chứng nhận hay ý kiến kiểm toán — đó là bằng chứng cho kiểm toán viên của bạn, người quyết định liệu nó có đủ hay không.
Mọi hạng mục trong danh sách kiểm tra bảo mật AI theo chuẩn ngành, được kiểm thử liên tục — và báo cáo nêu rõ những hạng mục nào đã được thử nghiệm, không chỉ những hạng mục nào tạo ra phát hiện. Ma trận đầy đủ được công bố trực tiếp tại Trung tâm tin cậy. Xem ngay →
Chúng tôi sẽ chạy một lần đánh giá thật trên một trong các tính năng dùng AI của bạn và cho bạn xem các phát hiện thực tế — không phải một bộ slide.